LLM・生成AI導入コンサルティング
活用設計・PoC・内製化まで、技術顧問として意思決定を支える
LLM を導入したいが、商用 API とローカル LLM のどちらにするか、RAG をどう組むか、ファインチューニングは要るのか。判断できる人が社内にいないまま、ベンダーの提案書だけが積み上がっていく。そんな状況のときにお声がけください。
私たちは自社で GPU クラスターを運用し、LLM の学習と推論を日常的に行っています。その経験をもとに、技術顧問として貴社の意思決定に必要な材料をそろえます。開発を丸ごと請け負うのではなく、技術調査、アーキテクチャレビュー、ベンダー提案の評価、経営層向けの説明資料づくりまで、判断の質を上げるところを担当します。
LLM/生成AI技術
技術選定・モデル開発・アーキテクチャ設計のアドバイザリー
最適な技術選定と導入戦略を、専門家の視点でアドバイス。
商用API vs オープンソースLLM、RAG構築の方針、ファインチューニングの要否など、 LLM導入における技術的な意思決定をサポートします。 技術調査レポートの作成、アーキテクチャレビュー、ベンダー提案の評価など、お客様の判断材料をご提供します。 また、PyTorch を用いたモデル開発・評価・推論など、LLM に限らない生成AIの基盤技術(Python / PyTorch)についてもアドバイザリーを行っています。
アドバイザリー領域
商用API vs ローカルLLM
- コスト比較・試算支援
- セキュリティ要件の整理
- レイテンシ・スループット評価
- ユースケース別の推奨
オープンソースLLM選定
- Llama/Mistral/Qwen等の比較
- 日本語性能の評価
- ライセンス・利用条件の整理
- モデルサイズと性能のトレードオフ
ファインチューニング戦略
- LoRA/QLoRAの適用可否判断
- 継続事前学習 vs ファインチューニング
- 必要データ量・コストの見積もり
- 効果測定方法のアドバイス
RAG設計レビュー
- アーキテクチャ設計のレビュー
- ベクトルDB選定のアドバイス
- 精度向上のための技術提案
- ベンダー提案の技術評価
モデル開発・評価・推論(Python / PyTorch)
- PyTorch によるモデル実装・学習
- 評価・ベンチマーク設計
- 推論の高速化・安全な実行
- LLM以外の生成AI・基盤技術
こんなご相談に対応
- LLM導入を検討中だが、技術的な判断ができる人材がいない
- PyTorch でのモデル開発・評価・推論まわりを技術レビューしてほしい
- ベンダーからの提案内容を第三者視点で評価してほしい
- 商用API vs ローカルLLM、コストとメリットを比較したい
- ファインチューニングの効果やコストを事前に見積もりたい
- 経営層向けにLLM導入の技術説明資料を作成してほしい
- LLM学習・推論に必要なGPU構成とコストを試算したい
ご提供できる知見(一例)
自社でGPUクラスターを運用し、LLMの学習・推論を日常的に行っている経験から、 以下のような専門的な知見をお伝えできます。これらは一例であり、お客様の課題に応じて幅広くご支援可能です。
LLM学習のリアル
フルスクラッチ学習、継続事前学習、ファインチューニングの違いと、それぞれに必要なGPU枚数・期間・コストの現実的な見積もり方をご説明します。
スケーリング則の理解
Chinchilla則に基づくモデルサイズとデータ量の最適バランス、MoE(Mixture of Experts)アーキテクチャの仕組みなど、最新の技術動向を解説します。
GPU選定・コスト試算
A100/H100/L40S等の特性比較、NVLinkの重要性、クラウドGPU vs オンプレミスのTCO比較など、実践的な情報をご提供します。
ご提供する価値
中立的な技術評価
特定ベンダーに依存しない立場から、お客様にとって最適な技術選定をアドバイスします。
実運用に基づく知見
自社GPUクラスターでLLMプロダクトを運用している経験から、机上の空論ではない実践的なアドバイスが可能です。
資料作成・会議参加
技術調査レポート、比較資料の作成、技術レビュー会議への参加など、意思決定を直接支援します。
関連リソース
Qualiteg BlogでLLM/生成AIに関する技術解説記事を公開しています。
GPT-6 AstraはAGIなのか Claude Fable 5.1との違い・料金・仕事への影響を解説
GPT-6 Astra(アストラ)は何がすごい?Claude Fable 5.1との性能・料金、ChatGPT ProとClaude Maxの20xプランを比較。AGIっぽさを感じる進歩と、実際の開発で気づいた点を図解で紹介します。

自宅PCのローカルLLMを外出先のスマホから使う。Ollama+Open WebUI+WireCanal
自宅PCのローカルLLM(Ollama+gemma4)にOpen WebUIでチャット画面を付け、トンネル経由で安全に公開して外出先のスマホから使うまでの実測手順。DockerもWSLもポート開放も不要です。

MCPサーバーの作り方 — 自作MCPサーバーをWeb版のChatGPT・Claudeから使えるようにする(後編)
自作MCPサーバーをWeb版のChatGPT・Claudeから使えるようにする手順を、実際に接続した画面つきで解説。公開URLとOAuth認証を付け、コードを1行も変えずにブラウザのAIから売上データベースへ日本語で聞けるようにします。
MCPサーバーの作り方 — PythonとFastMCPでデータベースにAIが日本語で答えるようにする(前編)
PythonとFastMCPでMCPサーバーを自作し、SQLiteの売上データベースにAIが日本語で答えるまでを、動くコードつきで最初から最後まで解説します。
Kimi K3 徹底リサーチ — 2.8兆パラメータ、「史上最大のオープンウェイト」は実現するか
Moonshot AI が発表した2.8兆パラメータの大規模モデル Kimi K3 を、公開情報と独立評価をもとにアーキテクチャから実装課題まで包括検証します。
Claude Fable 5はこれからどうなる? 経緯・コスト・今後の見通しをファクトベースで整理する
停止と復活、サブスク枠離脱までの経緯と確定した料金体系を、事実と推測を切り分けて整理。導入コスト試算の土台になります。
Mythos(ミュトス)レベルのオープンモデルはいつ出るのか
サイバーセキュリティ能力で人類トップ層に達したフロンティアモデル。オープンモデルが追いつく時期を、過去のオープン化ラグから数字で見積もります。
主要LLMプロバイダーのAPI料金表 — Claude / GPT / Gemini / Grok 【2026年5月13日時点】
Claude / GPT / Gemini / Grok の最新API料金を 1Mトークン単位で横並び比較。モデル選定・コスト設計の基礎資料に。
Anthropicが「強すぎて出せないモデル "Mythos"」を出した
一般公開されない最上位モデルと Project Glasswing が映し出す、防御側優位へのパラダイム転換を読み解きます。
日本語対応 LLMランキング2026 ~ベンチマーク分析レポート~(3月6日版)
Nejumi Leaderboard 4(2026年3月版)に基づく日本語対応LLMの最新性能分析。約3か月で勢力図はまた大きく動きました。
AIプラットフォーマーの垂直統合と、残された戦略オプション
AIプラットフォーマーがSaaS領域へ進出する垂直統合の構図と、その環境下で取りうる戦略オプションを考察します。
推論速度を向上させる Speculative Decoding(投機的デコーディング)とは
小さなモデルで先回り推論し、大きなモデルの計算負荷を下げる高速化技術を解説。
KVキャッシュのオフロード戦略とGQAの実践的理解
KVキャッシュをGPUのVRAMからCPU RAMやディスクにオフロードする戦略と、GQA(Grouped-Query Attention)によるKVキャッシュ削減技術を解説します。
公開から3日で停止──Fable 5/Mythos 5をめぐる米政府指令が示したAIの可用性リスク
公開直後に利用停止となった経緯から、AI活用の新しい可用性リスクを読み解きます。
ついに一般公開、Claude Mythos5/Fable 5 を実務視点で読み解く
同一基盤モデルにおける安全装置の差や、実務での使い分けをベンチマークとともに解説します。
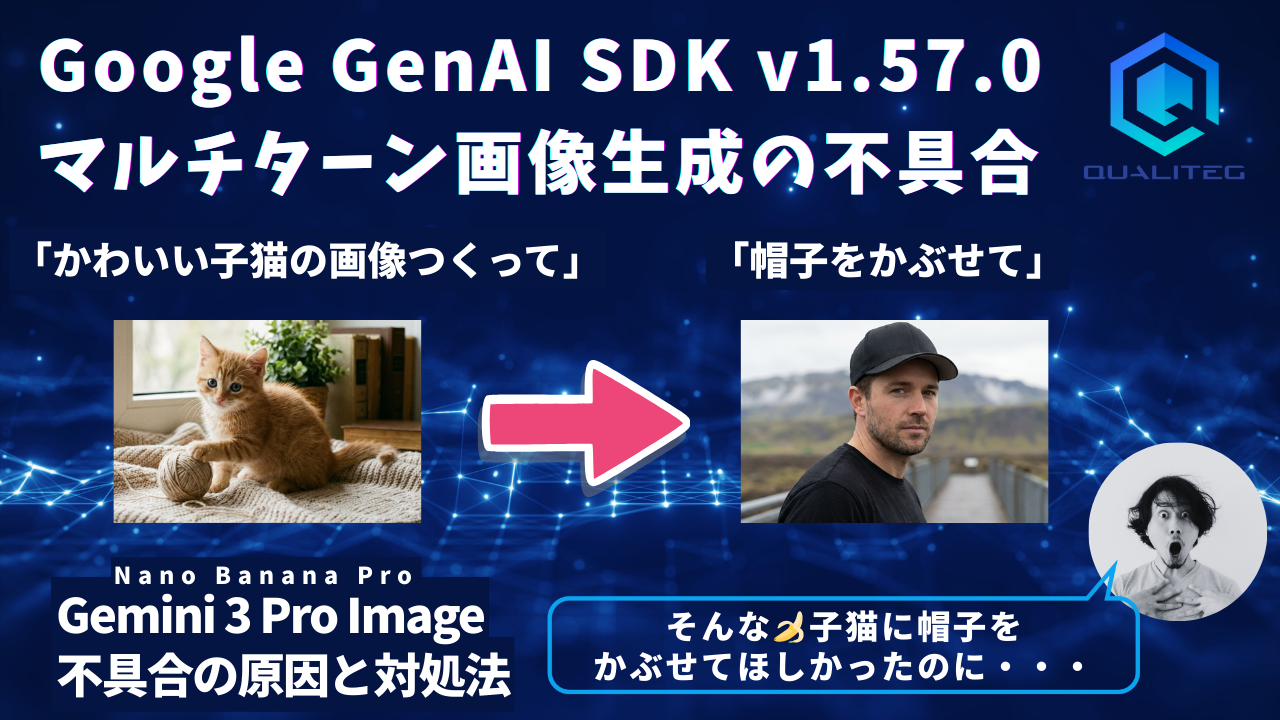
Google GenAI SDK マルチターン画像編集の問題と対処法
Gemini 3 Pro Imageのストリーミングでマルチターン画像編集が不安定になる問題と解決策を共有します。
LLM学習の現実:GPU選びから学習コストまで徹底解説
LLM学習に必要なGPU枚数・期間・コストの現実を、具体的な数字と事例で解説します。
Model Context Protocol完全実装ガイド 2025
MCPの仕様変遷から最新Streamable HTTPまで、完全なソースコードと共に解説します。
日本語対応 LLMランキング2025 ~ベンチマーク分析レポート~
Nejumi Leaderboard 4のベンチマークデータに基づく日本語対応LLMの総合分析レポートです。
【解説】Tekken トークナイザーとは何か?
Mistralが採用する新世代トークナイザーの特徴と、従来のトークナイザーとの違いを解説します。
日本語対応!Mistral Small v3 解説
24Bパラメータで70B以上に匹敵する性能を実現した、日本語対応の小型モデルを解説します。
「Open Deep Research」技術解説
HuggingFace社が開発したOpen Deep Researchのアーキテクチャと実装を詳しく解説します。

Meta社が発表した最新の大規模言語モデル、Llama 3.1シリーズの紹介
8B、70B、405Bの3サイズで提供されるLlama 3.1シリーズの特徴と性能を紹介します。
Mistral AI社の最新LLM「Mistral NeMo 12B」を徹底解説
Apache2ライセンスで公開された12Bパラメータモデルの特徴と性能を解説します。
革新的なコード生成LLM "Codestral Mamba 7B" を試してみた
Mambaアーキテクチャを採用した新しいコード生成LLMの試用レポートです。
ChatStream🄬でLlama-3-Elyza-JP-8B を動かす
GPT-4を上回る性能と言われる日本語LLM「Llama-3-Elyza-JP」の8B版を試してみました。
よくあるご質問
商用 API とローカル LLM、どちらを選ぶべきか判断できません。何を基準に決めますか。
コスト、セキュリティ要件、レイテンシとスループット、ユースケースの 4 点で比較します。機密データを外に出せない用途はローカル LLM、まず小さく試す段階は商用 API、という切り分けが多いですが、GPU 構成とコストの試算まで出したうえで、貴社の条件に合う方を一緒に決めます。
オープンソース LLM はどれを選べばよいですか。日本語の性能も気になります。
Llama、Mistral、Qwen などの候補を、日本語性能、ライセンスと利用条件、モデルサイズと性能のトレードオフで比較します。当社ブログで公開している日本語対応 LLM ランキングのように、ベンチマークの読み方も含めてご説明します。
ファインチューニングは本当に必要ですか。コストの見積もりもほしいです。
まず RAG やプロンプト設計で足りるかを確認し、それでも足りないときに LoRA/QLoRA の適用可否、継続事前学習との違い、必要なデータ量と GPU 枚数・期間・コストを見積もります。効果をどう測るかも先に決めておきます。
支援の形はどのようなものですか。開発も依頼できますか。
技術顧問・アドバイザリーとしての支援です。技術調査レポートの作成、アーキテクチャ設計レビュー、ベンダー選定の支援、技術資料の作成、会議への参加といった形で、貴社の判断材料を提供します。無料相談は初回のみ、1 時間程度までお受けしています。