自然言語処理・日本語PII検出の技術支援
敬称付き人名・日本の住所・文脈依存の金額まで、日本語に特化した検出とマスキング
多言語対応の PII 検出ツールを入れたのに、「山田部長」を人名として拾えない。住所の表記ゆれで漏れが出る。「年収 500 万円」と「売上高 500 万円」を区別できない。日本語の PII 検出には、英語圏のツールでは見えない難しさがあります。
私たちは長年にわたり自然言語処理を専門的に研究してきたチームを擁し、形態素解析や固有表現認識(NER)といった古典的手法から最新の Transformer・LLM まで、用途・精度・速度に応じた技術を保有しています。独自に構築したコーパスと日本語への理解をもとに、日本語専用の PII 検出・マスキングエンジンを製品化しました。その技術を、貴社の文書や業務フローに合わせて技術顧問として提供します。
自然言語処理/NLP
日本語特化の高度なテキスト処理・PII検出技術
日本語という言語の奥深さに寄り添う。
敬称付き人名、表記ゆれする住所、文脈で意味が変わる金額情報—— 多言語対応のPII検出ツールは、これらの日本語固有の難しさを十分にカバーできていません。 私たちは長年にわたり自然言語処理を専門的に研究してきた専門家チームを擁し、 形態素解析や固有表現認識(NER)といった古典的手法から、 最新のTransformer・LLMまで、用途・精度・スピードに応じた幅広いテクノロジーを保有しています。 独自に構築したオリジナルコーパスと、日本語の文化的背景への深い理解を武器に、 日本語専用のPII検出・マスキングエンジンとして実用化・プロダクト化を実現。 日本企業にとって真に実用的な自然言語処理ソリューションを提供します。
日本語という言語の美しさと複雑さ—そしてQualitegのアプローチ
汎用的な多言語対応ツールが100言語に対応するとき、各言語への投資は必然的に薄くなります。 日本語の複雑さに対応するには、ルールベースのヒューリスティックな手法と、機械学習・深層学習アプローチのバランスの取れた組み合わせが不可欠です。 私たちは日本語処理に特に深い強みを持ち、両方の技術を深く理解した上で課題に応じて最適な手法を選択・統合できることを強みとしています。
世界でも稀な多層的文字体系
ひらがな、カタカナ、漢字、ローマ字、数字。これらが有機的に組み合わさることで豊かな表現力を生み出しています。 一つの企業名でも「株式会社国際情報技術研究所」「KJK研究所」「ケージェーケー研究所」など多様な表記が可能であり、 この柔軟性はコンピューターによる処理を困難にする要因でもあります。
文脈が意味を決定する言語
「三沢から連絡がありました」—これは人名?会社名?地名?日本語では文脈なしには判断できません。 英語なら"Mr. Misawa"(人名)、"Misawa City"(地名)と明確に区別されますが、 日本語では前後の文脈を広く見る必要があります。
敬語システムが提供する情報
「山田が来ました」「山田さんが来ました」「山田様がいらっしゃいました」「山田先生がお見えになりました」— 敬称の種類によって人物の立場や、どの程度のマスキングが必要かを判断できます。 敬語は単なる礼儀ではなく、話者間の関係性、社会的地位など多層的な情報を含んでいます。
技術領域
PII(個人識別情報)検出
- 日本語特化PII検出エンジン
- 敬称駆動型人名検出
- 日本の住所体系への完全対応
- 電話番号・メール等のパターン検出
- 文脈を考慮した高精度検出
固有表現認識(NER)
- 人名・組織名・地名の識別
- 日本語コンテキスト強化器
- 機械学習ベースNER
- Transformerベース深層学習
形態素解析・構文解析
- 各種形態素解析エンジン活用
- カスタム辞書構築
- 品詞情報を活用した文脈判断
- 係り受け解析
- 専門用語・新語への対応
テキストマスキング・非識別化
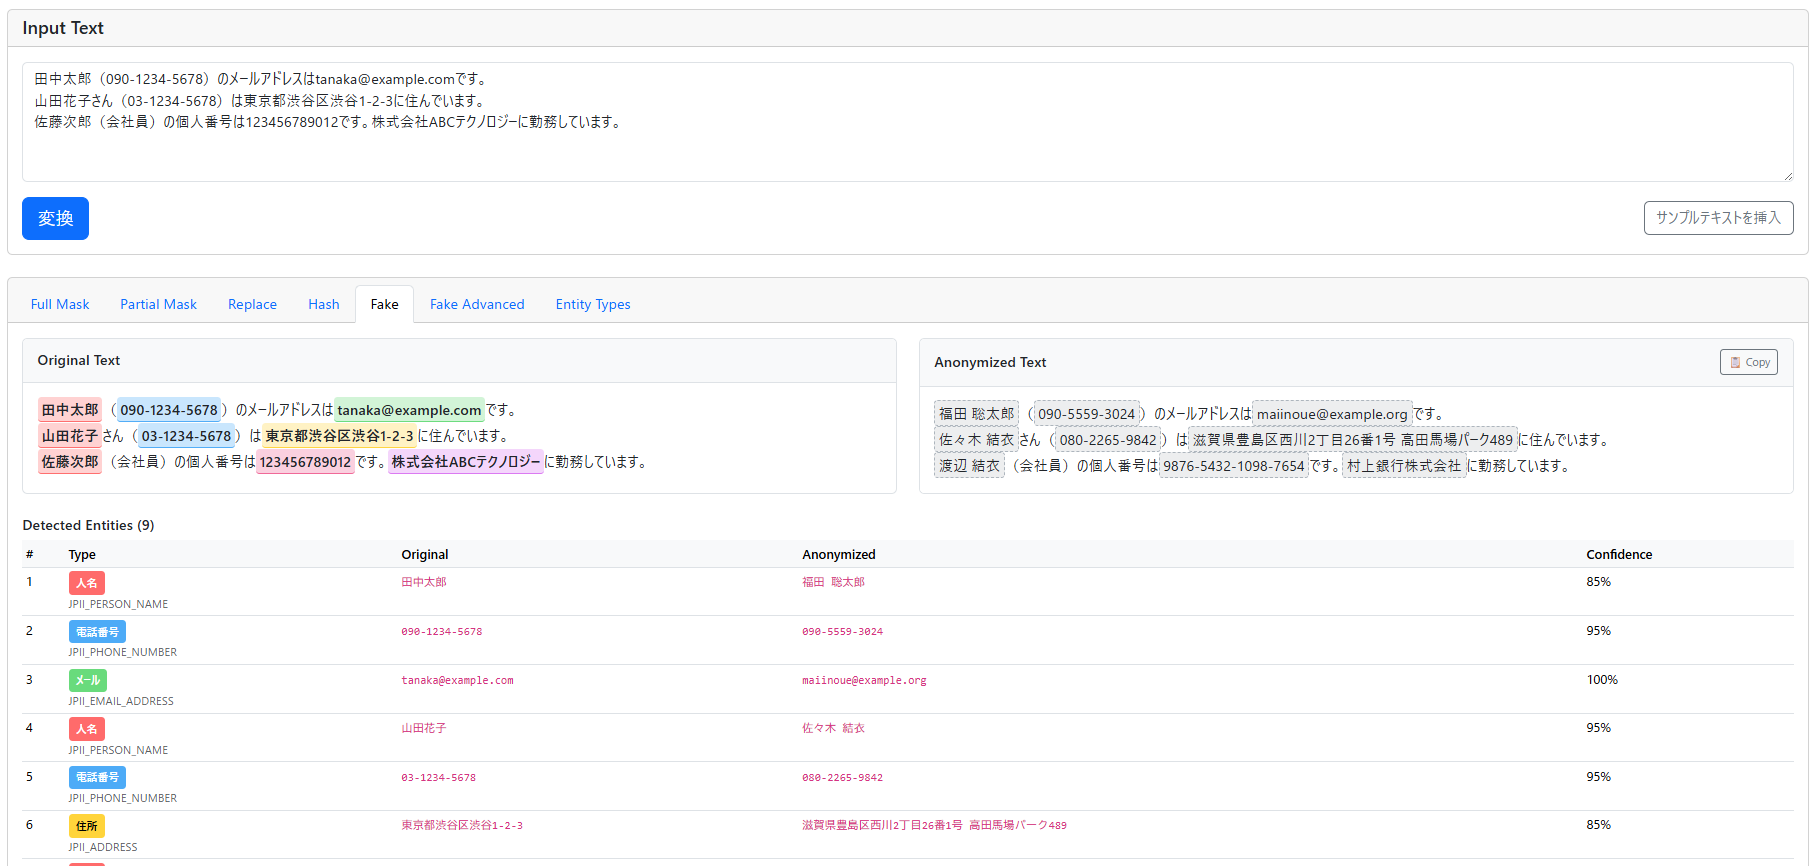
- 5種類の非識別化方式(置換・マスク・ハッシュ化等)
- LLM活用前の安全なPIIマスキング
- リバーシブル仮名化(復元可能な非識別化)
- DLP・SIEM・LLMワークフローへの組み込み
- 文脈を理解した機密情報の分類と処理
処理レベルと精度・速度のトレードオフ
実際のビジネスシーンでは、用途・目的・セキュリティ基準に応じて速度と精度のバランスを柔軟に調整する必要があります。 私たちは5段階のアプローチで、データの重要度に応じた最適な処理レベルを提案します。
超高速スキャン
数万件/秒以上正規表現による高速パターンマッチング。電話番号、メールアドレス、クレジットカード番号など形式が明確な情報を瞬時に検出。
文脈解析パイプライン
数千件/秒大量ドキュメントから文脈パターンを自動学習し、検出精度を向上。同じ数値でも「年収」と「売上高」を区別するなど、意味レベルの判定を実現。
高精度NER
数百件/秒機械学習による高度な固有表現認識。文全体の構造を考慮した柔軟な判定。
広域文脈理解
100件/秒Transformerベースの深層学習モデルによる文書全体の文脈理解。NERを超え、長距離の依存関係や暗黙的な情報まで推論。
LLM統合モード
数十件/秒大規模言語モデル統合。人間レベルの言語理解で、略語、専門用語、暗黙の参照関係も理解し適切なマスキングを提案。
こんなご相談に対応
- 多言語対応ツールでは日本語のPII検出精度が不十分で、漏れや誤検出が発生している
- LLMに社内データを入力する前に、個人情報を安全にマスキングしたい
- 「年収500万円」と「売上高500万円」を文脈から区別して適切に処理したい
- 契約書や議事録から特定の情報を自動抽出・マスキングしたい
- 既存のDLP・SIEM・LLMワークフローにPII検出を組み込みたい
- 社内文書から人名・組織名・製品名を正確に抽出したい
- 敬称付き人名(「山田部長」「田中様」等)や日本特有の住所表記にも対応したPII検出が必要
ご提供できる知見(一例)
日本語の自然言語処理技術について深い知見を持ち、実際にPII検出・マスキングプロダクトを開発・運用している経験から、 以下のような専門的な知見をお伝えできます。これらは一例であり、お客様の課題に応じて幅広くご支援可能です。
日本語特化の検出ロジック
敬称駆動型検出(「様」「さん」を手がかりにした人名特定)、階層的パターンマッチングによる住所検出など、日本語の文化的特性を活かした検出技術を解説します。
多層的フィルタリング技術
形態的フィルタリング、統計的フィルタリング(姓名データベース照合)、文脈的フィルタリング、除外リスト適用など、複合的なアプローチで精度を高める手法をご紹介します。
最適化技術の適用
量子化によるモデルサイズ削減、動的バッチングによるGPU利用効率向上、知識蒸留による軽量モデル作成など、「高精度だが軽量」を実現する技術をお伝えします。
Qualitegの強み
長年の研究と専門家チーム
自然言語処理を専門的に研究してきた専門家チームが在籍。形態素解析やNERから最新のTransformer/LLMまで、技術の変遷を熟知した上で最適解を提案します。
オリジナルコーパスと実用化実績
独自に構築した日本語コーパスを保有し、PII検出エンジンとして実用化・プロダクト化を達成。理論だけでなく、本番環境で動作する実装力があります。
ヒューリスティック×機械学習の融合
日本語の複雑さにはルールベースの緻密な対応と、深層学習による汎化能力の両方が必要。両技術を深く理解し、課題に応じて最適に組み合わせます。
フルスタックな技術対応力
形態素解析や固有表現認識(NER)からTransformer/LLMまで。用途・精度・スピード要件に応じた幅広い技術を提供できます。
日本語処理に特に深い強み
多言語対応の汎用ツールでは対応しきれない、日本語の敬称体系、漢字の多義性、住所の階層構造、電話番号の多様性など、日本語固有の課題ひとつひとつに専用の検出ロジックを組んでいます。
柔軟なレベル設計
用途・予算・セキュリティ要件に応じて、5段階の処理レベルから最適なアプローチを提案。過剰な精度追求によるコスト増を防ぎます。
LLM-Audit
「LLM-Audit」は、企業のLLM活用を包括的に監査するセキュリティソリューションです。 社員からLLMへの送信(アウトバウンド)と、LLMからの応答(インバウンド)の双方向監査を実現。 プロンプトインジェクション対策、ジェイルブレイク攻撃防御、有害コンテンツの検出・ブロックなど、 企業のAI活用におけるセキュリティとコンプライアンスを強化します。
PII-Fi™ API
「PII-Fi™ API」は、当社が長年培ってきた日本語NLP技術を凝縮した、日本語専用のPII検出・マスキングクラウドAPIです。 敬称付き人名、表記ゆれする住所、文脈依存の機密情報まで高精度に検出。 5種類の非識別化方式とリバーシブル仮名化に対応し、APIひとつで既存のDLP・SIEM・LLMワークフローに組み込めます。 このPII検出エンジンの実用化・プロダクト化の実績が、私たちの日本語NLP技術力の証明です。
関連リソース
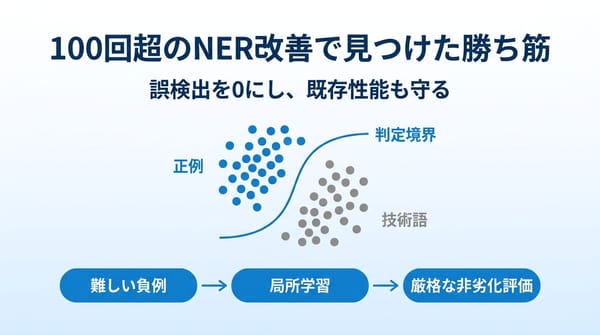
誤検出を0にしても採用しない NER改善100回超の勝ち筋
NER モデルの誤検出をハードネガティブ抽出・知識蒸留・エンティティ種別ごとのスコア調整で解消しつつ、既存性能を守り抜いた100回超の改善実験の記録です。
モデルを「壊さずに」ドメインを広げる ― XLM-RoBERTa 継続学習の設計ノート
素朴な追加学習でPrecisionが0.83→0.17に崩壊。PII検出エンジン開発で直面した破滅的忘却と、壊さずにドメインを広げる継続学習の設計。
個人情報検出の精度を、どう正しく語るか ― Recall・信頼区間・代表性
PII検出の精度を誠実に評価・報告するための、統計的な評価設計の考え方を解説します。
PII検出の混同行列では見えないもの ― 認識器間衝突と統合テスト
個人情報(PII)の自動検出における認識器間衝突の問題と、それを検出するための統合テスト設計について解説します。
Python と JavaScript で絵文字の文字数が違う!サロゲートペアが引き起こす位置ずれバグの話
PII検出のハイライトが絵文字入りテキストでずれる。PythonとJavaScriptの文字数定義の違いが引き起こす位置ずれバグと対策です。
PIIの高精度検出を支える技術~日本語という言語の奥深さに寄り添う~
グローバルツールと日本語特化ツールの共存。日本語の独特な文字体系と文化的背景に深く寄り添い、日本企業に実用的なPII検出ソリューションを提供します。
よくあるご質問
既存の多言語対応ツールでは日本語の PII 検出精度が足りません。何が違いますか。
敬称駆動型の人名検出、日本の住所体系への対応、文脈を考慮した判定です。同じ数値でも「年収」と「売上高」を区別するような意味レベルの判定を、大量ドキュメントから文脈パターンを学習することで実現します。
LLM に社内データを入力する前に、個人情報を安全にマスキングしたいです。
置換、マスク、ハッシュ化などの 5 種類の非識別化方式と、復元可能なリバーシブル仮名化に対応しています。既存の DLP・SIEM・LLM ワークフローへの組み込みまで含めて設計します。
速度と精度のどちらを優先すべきですか。
用途と重要度で決めます。正規表現による超高速スキャン(Level 1)から、文脈解析パイプライン、高精度 NER、Transformer による広域文脈理解、LLM 統合モード(Level 5)まで 5 段階のアプローチを用意し、ログ分析には Level 1、取締役会議事録や重要契約書には Level 5 というように、データの重要度に応じた処理レベルを提案します。
契約書や議事録から特定の情報を抽出することもできますか。
はい。人名・組織名・地名・製品名の識別、係り受け解析や品詞情報を使った文脈判断、専門用語や新語へのカスタム辞書対応により、契約書や議事録からの情報抽出とマスキングを支援します。